AO2 FIELD GUIDE · AG008 · GEO/AEO 與 AI 搜尋
AI 爬蟲阻擋排查從實際網址、請求身分、時間與防護事件查起,再區分 robots、CDN、WAF 與來源站。附交接單與回查表,不因沒被引用就停用防護,也不把 User-Agent 當成身分證。
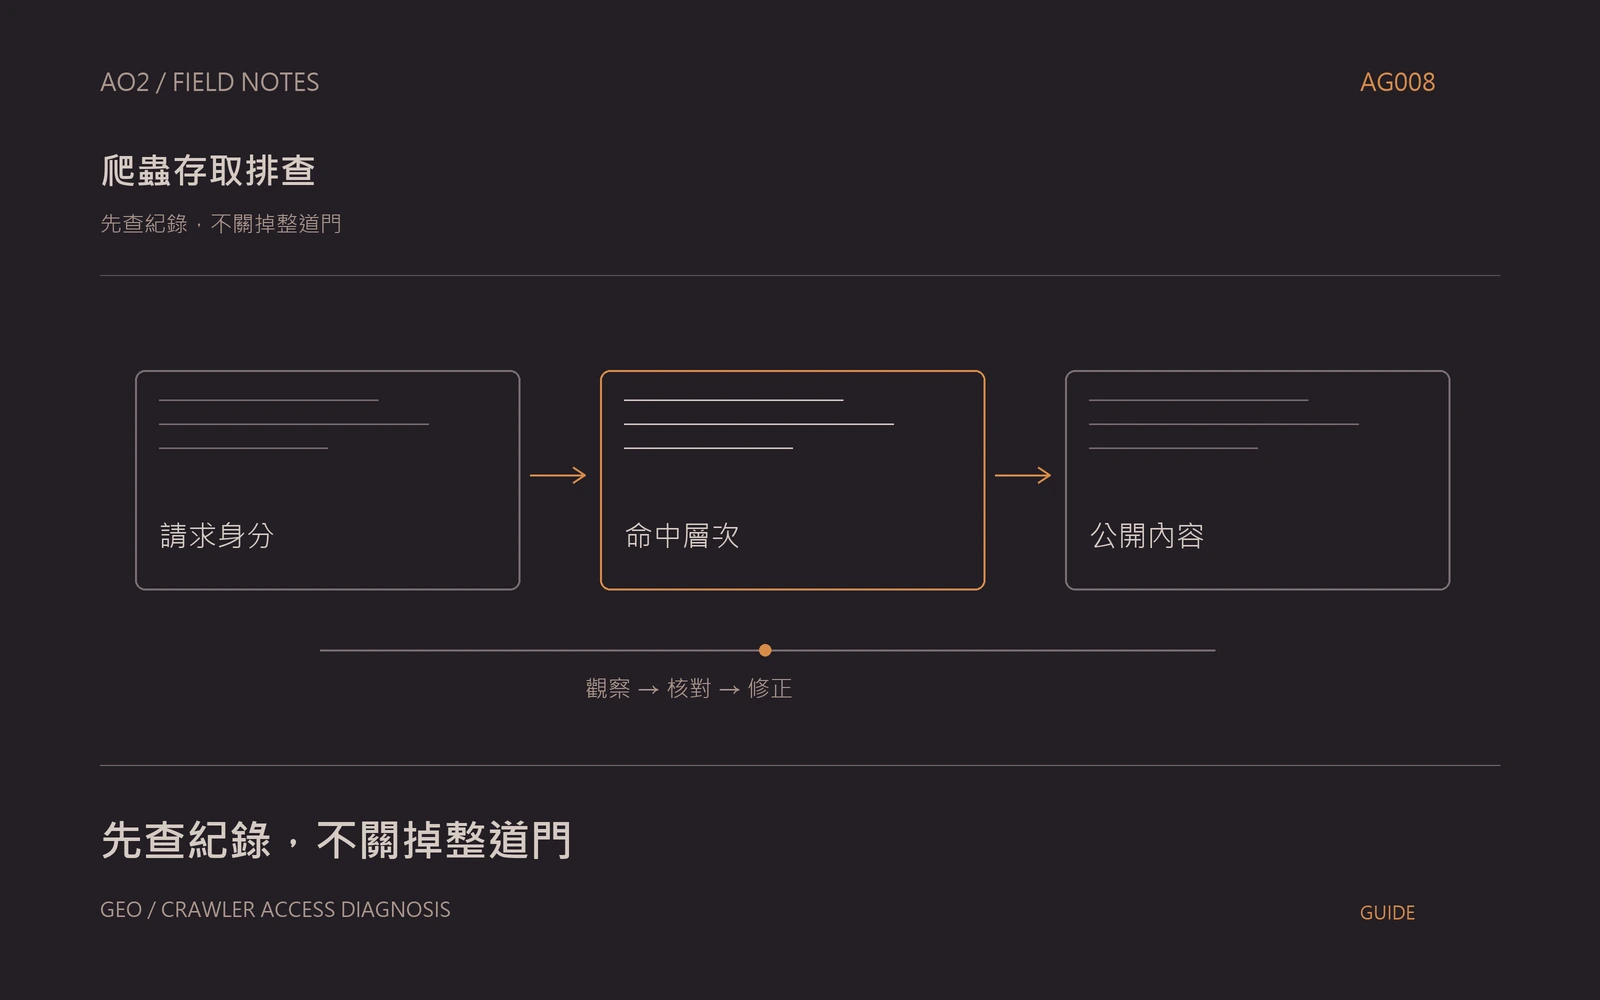
網站自己打得開,AI 卻說無法讀取,要把防火牆關掉嗎?先查這次請求真的到了哪一層、由誰發出、收到什麼內容。引用缺席有很多可能原因,沒有請求證據時,不能直接怪罪網站防護。
AI 爬蟲阻擋排查,先證明是哪一個請求
先保存完整網址、日期時區、觀察平台與錯誤原文,請有權限的維護者核對相應請求及防護事件。若找不到同時段紀錄,寫成尚未證實,不把沒有品牌出現當成抓取失敗。來源可能尚未被請求,也可能引用其他資料;這些都不能只靠一次答案判定。
先找證據指向哪一層,再決定是否需要改設定。本篇是維護排查方法,不是要求直接關閉 WAF 或開放全部機器人。robots 與 noindex 的用途另有文章;這裡處理已觀察到的存取問題、請求身分及回應。任何正式變更都由網站權責人按最小範圍與現行設定評估。
白話例子:快遞沒進門,先看門房紀錄
假想產品文件在瀏覽器可讀,某服務卻回報取得失敗。這像快遞說進不了大樓:先看他是否到對門、來訪時間、報的是哪家公司,以及門房怎麼處理。不能因一次失敗就拆掉大門,也不能只因制服寫某個品牌,就認定來訪者身分是真的。
大門對應 CDN 或 WAF,門房紀錄對應防護事件,內部房間則是來源站與檔案權限。這是說明排查順序的假想比喻,並非本站已發生阻擋。真實請求可能經不同基礎設施與快取路徑;同一網址在你的登入瀏覽器成功,不能代表未登入機器人取得完全相同的內容。
先驗身分與用途,不只看 User-Agent
請求自稱某個爬蟲,仍需依該供應商官方方法核對。Google 提供其爬蟲及取得器的驗證文件;Cloudflare 亦有 Verified bot 的身分與行為分類。這些是各自系統的辨識方法,不表示任何帶相似名稱的請求都應放行,也不表示所有已驗證服務都符合企業希望公開的用途。
把已知用途分開記錄,例如建立搜尋索引、使用者觸發取得或其他資料使用,再對照網站公開政策。不要將某一種用途的允許或拒絕,推成全部 AI 功能相同結果。記錄時遮蔽不必要個資與權杖;交接提供足以定位事件的資訊即可,不把原始機密日誌貼到公開文章或任意工具。
| 項目 | 應保存 | 避免 |
|---|---|---|
| 目標 | 完整公開網址與預期內容 | 只說 AI 看不到 |
| 時間 | 日期、時區與事件識別 | 拿不同時段日誌配對 |
| 身分 | 官方驗證與用途 | 只信 User-Agent 名字 |
| 回應 | 命中層、動作與實際內容 | 只看成功或失敗總分 |
沿 CDN、防護與來源站找實際回應
先看防護事件是否有命中規則及處理動作,再比對來源站是否收到請求。若停在邊緣層,查該層回應;若已到站,查登入、權限、網址、快取與內容。成功狀態也可能包著驗證頁、空白或錯誤訊息,因此要核對實際主內容,而不是只看一個綠色狀態。
區分拒絕、挑戰、頻率限制與來源站錯誤,另核對 robots 和索引規則。Cloudflare 對誤判提供產品別排查方式,具體選項依方案與版本核對;本文不給一條能套所有網站的放行規則。先用最小必要範圍定位,避免把私人附件、管理入口或其他服務一起納入例外。
交辦修正後,用同條件回查
工作單列確認的請求、受影響公開資源、命中層、原始回應、預期內容與責任人。若確需設定調整,先留原值、變更範圍、回復方法與驗證方式;回查取得與站內功能,再保留防護事件是否仍符合預期。不要因測試成功,就把有限例外擴成全站永久放行。
能讀到正確公開內容,與一定被引用,是兩層結果。存取問題修好後,引用與索引仍可能受其他因素影響。先結案已證實的技術缺口,再安排外部觀察;找不到原因時保留待補證據,不用關掉防護換一個難以解釋的測試結果,也不對重試次數或等待時間作通用保證。
| 觀察 | 先查什麼 | 回查重點 |
|---|---|---|
| 邊緣層有事件 | 命中規則與處理動作 | 最小範圍及公開內容 |
| 來源站收到請求 | 登入、權限、快取與路徑 | 最終回應和主內容 |
| 沒有相應請求 | 時間與可用紀錄範圍 | 保留尚未證實 |
| 取得正常但無引用 | 轉外部答案與內容觀察 | 不再假設是阻擋 |
常見問題
AI 沒引用官網,就表示 WAF 擋住了嗎?
不能直接判定。先保存題目、答案、網址與時間,核對是否有相應請求及防護事件。若沒有證據,可能是未請求、改用其他來源或其他尚未知原因,應保留待確認。只有確認存取缺口後才安排對應技術工作;沒有引用不是關閉防護或大範圍放行的充分理由。
延伸閱讀:想出現在 Google AI 搜尋,需要另外做什麼設定?
看到 Googlebot 或 AI 名稱,就可以放行嗎?
請求名稱可以被自稱,應依供應商官方方法或既有可靠身分機制核對,再確認用途與網站公開範圍。已驗證身分也不是無限制存取的許可。對特定公開資源的例外,仍需由權責人評估並保留回查;管理、私有文件與其他不相關資源不能跟著一起開放。
延伸閱讀:想出現在 Google AI 搜尋,需要另外做什麼設定?
伺服器回傳 200,但內容是驗證畫面,算 AI 已讀到網站嗎?
不算。200 只說明收到某種成功回應,還要核對回應內是否真的有產品正文,或其實是驗證、登入與挑戰畫面。同時確認請求身分、時間及相關伺服器紀錄。
這像簽收了信封,裡面卻沒有信。先修正阻擋或錯誤回應的原因,再驗證可取得的內容;不能只憑狀態碼宣稱 AI 已讀到或一定會引用。
已登入的瀏覽器可能和未登入的請求使用不同快取或防護路徑,不能只看自己的畫面。修正後要重查預期主內容及防護範圍,外部引用結果另作觀察。
延伸閱讀:想出現在 Google AI 搜尋,需要另外做什麼設定?
白話總結:快遞進不來,先查門房紀錄
用實際請求定位,不用猜測停用整站防護。
- 留事件:保存網址、時間、錯誤及預期公開內容。
- 查層次:核對身分、防護動作與來源站回應,未知明說。
- 小範圍回查:由維護者評估修正,保存原值與結果,引用另觀察。
完成條件:技術工作有請求與回應證據,只處理確認的缺口,沒有為取得內容而開放不相關資源。
來源與方法範圍
資料查核:2026 年 10 月 24 日。來源支持文中對應的準則與平台說明;工作表、判斷步驟及已標示的假想情境由 AO2 整理,實際使用時依產品資料與現行設定核對。