DATA 12 / OPERATIONS
AI 做得更快,為什麼仍可能答錯?把任務邊界放進自動化流程
讀懂 2026 年正式期刊中的能力邊界實驗,讓自動化有可核對的停點。

一套 AI 在整理資料時表現很好,不代表它在同一份資料上的推論也可靠。任務能力的邊界可能很不平整:看似相近的工作,一個容易完成,另一個卻會產生有說服力的錯誤。自動化設計需要辨認這些差異,並保留可以停下、核對與恢復的路徑。
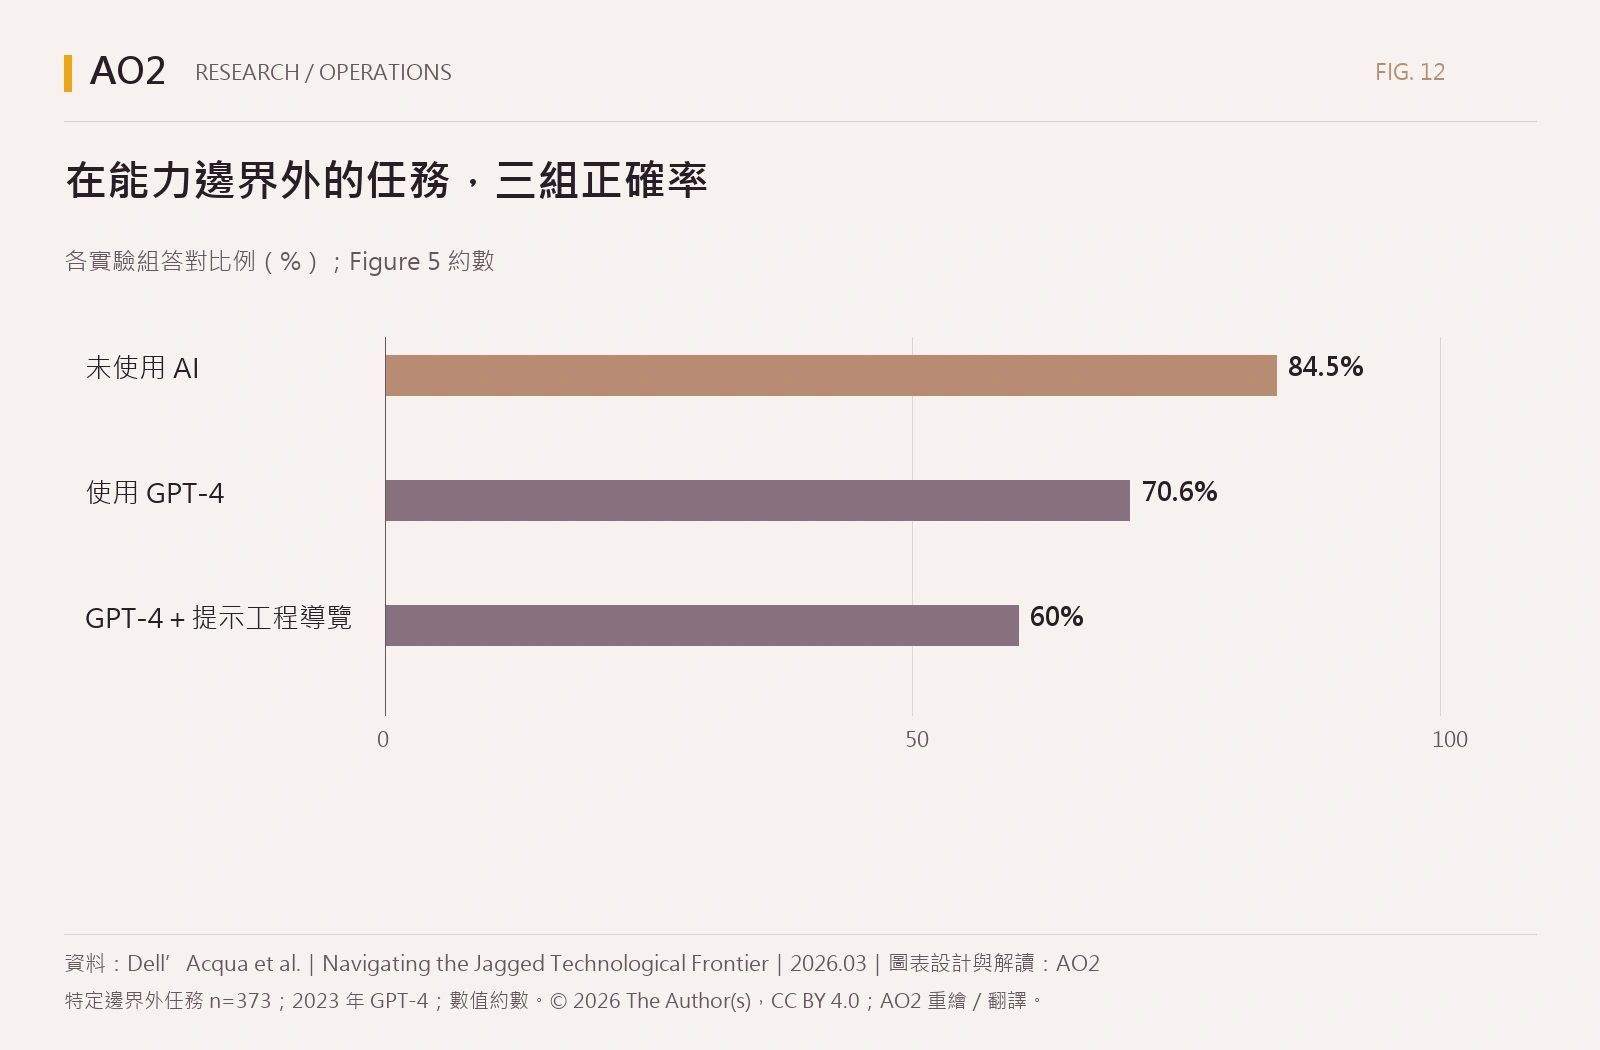
查看圖表數據與單位
| 項目 | 數值 |
|---|---|
| 未使用 AI | 84.5 |
| 使用 GPT-4 | 70.6 |
| GPT-4+提示工程導覽 | 60 |
以下為 AO2 的企業應用解讀與實作建議。
ADDITIONAL EVIDENCE / AHREFS · 2026.10.23
補充研究:人工審查是信任條件,卻不等於審過就一定對
Ahrefs 的信任題中,66% 表示只有人工審查後才信任 AI 內容,2.7% 表示沒有人工審查也信任。這是態度分布,不能當作內容正確率或人工審查成功率。

查看補充圖數據與單位
| 項目 | 比例 |
|---|---|
| 僅在人工審查後才信任 | 66% |
| 沒有人工審查也信任 | 2.7% |
和原有研究的共通點
原文的任務邊界實驗與這份問卷都讓「把輸出直接當答案」顯得不夠。前者用任務結果觀察錯誤,後者呈現使用者期待有人把關。共同的實作方向是把核對責任寫進流程,而不是只在最後加一個核准按鈕。
差異在哪裡,為什麼不能直接比較?
正式實驗比較特定任務中不同實驗組的結果;問卷詢問行銷人員的信任條件。覺得需要人工,不代表人工已經看得出錯誤。兩份資料都不能保證「只要人審過,AI 就可以處理任何任務」,更不能拿態度百分比推算實際錯誤率。
| 資料 | 量到什麼 | 不能推論什麼 |
|---|---|---|
| Ahrefs|2026 AI 內容製作問卷 2026-09-30 | 301 位受訪行銷人員的自陳問卷,280 位表示使用 AI 製作或協助製作內容。速度題以 AI 使用者為群體;信任題與採用題的分母依原題保留。 | 不是代表全體企業的隨機抽樣,也不是追蹤同一群人的控制實驗;感覺更快、使用普及、信任與商業成效各是不同問題。部分子題有效回答人數未個別列出。 |
回到企業,可以怎麼做?
把審查拆成可重現的任務:數字回到原表,規格核對有效版本,推論標出依據,不確定的例外轉交熟悉業務的人。再把容易漏看的難題放回驗收題集。若審查者無法取得來源,流程就應停下補資料;不要讓另一個 AI 的同意代替獨立證據。
再用一個 AI 檢查,能取代人工與原始來源嗎?
可以協助找出疑點,但不能把第二次同意當作驗證完成。兩個系統可能沿用相同錯誤。關鍵數字、產品條件與會影響決策的說法,仍需要回到可核對的資料與明確負責人。
以上實作方式與比喻為 AO2 的解讀及建議,並非研究量測的客戶成效。查核:2026-10-23。
不要把工具名稱當作任務保證
同樣是處理一份報表,擷取欄位、整理摘要、辨認異常與提出因果解釋,需要不同能力。流程規劃時應拆開輸入、轉換、推論與執行,分別決定如何驗證。某一步通過測試,不能自動替下一步背書。
對錯誤成本較高的步驟,應保留更直接的核對。例如金額加總交由明確計算規則,規格引用回到核准來源,對外建議要求支持證據。模型說得有條理,並不等於它已完成必要驗證。
用困難案例找出停點
測試題集除了正常案例,也要包括缺資料、相互矛盾的文件、接近限制的數值及看似合理的錯誤前提。先定義何種情況應補問、拒絕執行或轉交,再看系統能否辨認,而非等到上線後才由使用者發現。
轉交需要帶著資訊:原始輸入、已完成步驟、不確定原因與待確認項目。若只回覆「請聯絡我們」,既不利於接手,也很難追查流程出了什麼問題。
讓流程有復原能力
自動化不只需要成功路徑,也需要重試、停止與撤回設計。對會修改資料或送出訊息的步驟,確認執行結果、避免重複處理,並保留必要紀錄。模型、來源或規則更新後,使用相同測試重新驗收,才能知道原本的邊界是否改變。

如何知道有沒有改善?
以下指標是建議的內部驗收方式。先固定定義與觀察範圍,再比較結果;本文不替企業預設目標值或保證增幅。
- 分任務正確性
- 以事先定義的標準檢查各子任務,保留難題與失敗類型,不只報整體平均。
- 正確停止及轉交
- 分開記錄應停止卻執行、應通過卻攔下,以及交接資訊是否完整。
- 復原結果
- 測試重試、重複輸入與執行失敗時,是否能維持資料一致並回到可處理狀態。
常見問題 FAQ
這個研究證明 AI 一般都比人差嗎?
沒有。圖表只呈現特定能力邊界外任務;研究問題在於不同任務的能力差異,不能將單一任務結果推廣到所有工作。
為什麼加提示教學仍未更好?
該組在這個任務中沒有取得較高正確率,但不能據此斷言提示教學普遍有害。設計流程時仍應以具體任務測試,而不是依賴通用技巧。
2026 年出版,為什麼使用 2023 年模型?
資料蒐集與正式出版存在時間差。本文同時標示出版年與模型版本,避免把研究結果誤認為當代模型的即時測試。
如何判斷某一步能否交給 AI?
先定義輸入、合格輸出及錯誤代價,再用真實與困難案例測試。若無法可靠驗證,宜保留人工判斷或縮小自動執行範圍。
系統轉交很多問題,是否表示沒有價值?
要看它是否正確辨認邊界,以及有沒有完成有用的前置整理。能避免不當執行並提供完整交接,可能比盲目提高完成率更有用。
SOURCES & SCOPE
資料來源與適用範圍
Dell’Acqua et al.|Navigating the Jagged Technological Frontier · 2026.03
研究方式:Organization Science 正式版,2026/03/11;758 位 BCG 顧問,使用 2023/04 版 GPT-4。圖為能力邊界外任務的 373 人實驗臂(129/119/125)。
解讀邊界:單一設計的品牌分析任務;圖採 Figure 5 的約數 84.5/70.6/60,不是目前所有模型的正確率。
Organization Science. Copyright © 2026 The Author(s). CC BY 4.0. AO2 redrawing and translation. 研究 DOI · CC BY 4.0 授權。圖表保留研究數據,重繪、中文標示與企業應用解讀由 AO2 完成。
查核日期:2026-10-23。本文的企業情境、實作步驟與驗收建議為 AO2 原創整理,與研究實測結果分開呈現。
本次補充:Ahrefs|2026 AI 內容製作問卷(2026-09-30)。方法與限制見補充研究表格。